Misschien ben je het in de afgelopen week tegengekomen: er is een nieuw soort AI-model verschenen. Het bedrijf erachter is TypeSafe en zij kondigden dit model, genaamd Jev, aan in hun blogartikel.
Al snel werd het internet overspoeld door berichten hierover. Er was al direct een grote vraag naar dit model; zelfs dusdanig groot dat de officiële API-servers enige tijd platgingen. Wij hebben daar natuurlijk ook aan bijgedragen, want ook bij Webenable waren we dit model aan het uitproberen. Het leek ons dus ook wel leuk om hier een kort artikel over te schrijven.
Enkele prestaties
Waarom is het internet zo in rep en roer over dit nieuwe model? Door de combinatie van hoe goedkoop en hoe snel het model is. Afhankelijk van waar je het mee vergelijkt, is het model namelijk tien tot honderd keer goedkoper en tien tot honderd keer sneller, maar levert het wel vergelijkbare 'intelligentie'.
Hier zijn enkele van de 'prestaties' die we voorbij zagen komen.
Doom spelen
De onderstaande tekst van de makers spreekt voor zich:
Jev is so fast it can play Doom. Every decision, where to move, where to aim, whether to hold down the trigger, Jev is making those decisions inside the software loop, responding at about 100 milliseconds per battery of questions. It's able to make 10 decisions a second, which is fast enough to track enemies and fire effectively and dodge projectiles.
Bulkclassificatie van e-mail
Ontwikkelaars gebruiken Jev om de e-mails in hun inbox te classificeren (bijvoorbeeld als spam of fraude). Het classificeren van honderden e-mails gebeurde in enkele seconden en voor een paar cent.
Stuk rustiger op die manier.
Vlucht boeken via Google Flights
Jev was in staat om als browseragent te functioneren en binnen enkele seconden een vlucht te kiezen. De code van deze agent is open source en is te vinden op GitHub. Dit project had binnen enkele dagen al meer dan tienduizend sterren.
Ik ben niet bepaald de doelgroep, maar wel gaaf dat het kan.
De naam
Waarom heet het model eigenlijk Jev? De naam verwijst naar de paradox van Jevons: het economische verschijnsel waarbij iets efficiënter en goedkoper maken er juist toe kan leiden dat we er méér van gaan gebruiken. TypeSafe verwacht hetzelfde bij AI: hoe goedkoper intelligentie wordt, hoe meer toepassingen ervoor ontstaan.
Het verschil met andere modellen
Maar als dit model zoveel goedkoper en zoveel sneller is - is het dan niet tijd dat we allemaal direct overstappen op dit model? Weg met Fable en Astra, welkom Jev!
Jev is heel gaaf, maar ik zou toch nog heel even wachten voordat je je abonnement van OpenAI en/of Anthropic stopzet.
Het grote verschil tussen Jev en 'normale' LLM's is dat Jev niet in staat is om zelf tekst te genereren. Een LLM bestaat (versimpeld) uit twee onderdelen: het 'parsen' van de tekst en het 'genereren' van nieuwe tekst. Denk hierbij bijvoorbeeld aan een chatbot. De chatbot 'leest' je tekst en reageert daarna met nieuwe tekst.
Jev kan dit niet; Jev is alleen in staat om keuzes, scores en kansen terug te geven, en doet dit op basis van data en keuzes die de developer zelf moet aanleveren.
Dat klinkt misschien ingewikkeld, dus proberen we dit uit te leggen met een voorbeeld.
Voorbeeld verschil tussen Jev en 'normale' LLM's
Scenario: ik heb een foto (van mijzelf) en ik wil aan Jev vragen om te classificeren wat voor dier er op de foto staat. Om dit te bereiken moet ik Jev voorzien van drie stukken informatie:
- De foto
- De vraag
- De keuzes. Bijvoorbeeld: gorilla, varken, paard.
Je MOET dus deze lijst van keuzes meegeven. En daar zit het grote verschil met een normale LLM. Daar zou het voldoende zijn om alleen de foto te sturen, samen met de vraag.
We stellen de vraag aan Jev, en die geeft als antwoord: een gorilla (met 41% kans, en met zo'n 11% vertrouwen in dat antwoord).
{
  "model": "typesafe/jev-1.13-20260917",
  "answers": {
    "animal": {
      "type": "choice",
      "choice": "Gorilla",
      "probabilities": {
        "Gorilla": 0.41,
        "Horse": 0.32,
        "Pig": 0.27
      },
      "confidence": 0.11
    }
  },
  "usage": {
    "input_tokens": 376,
    "output_tokens": 43,
    "cost": 0.000015792
  },
  "id": "gen-dec-1789985622-ZKOTKdDNI6JF1vB5Ap8b",
  "provider": "TypeSafe"
}
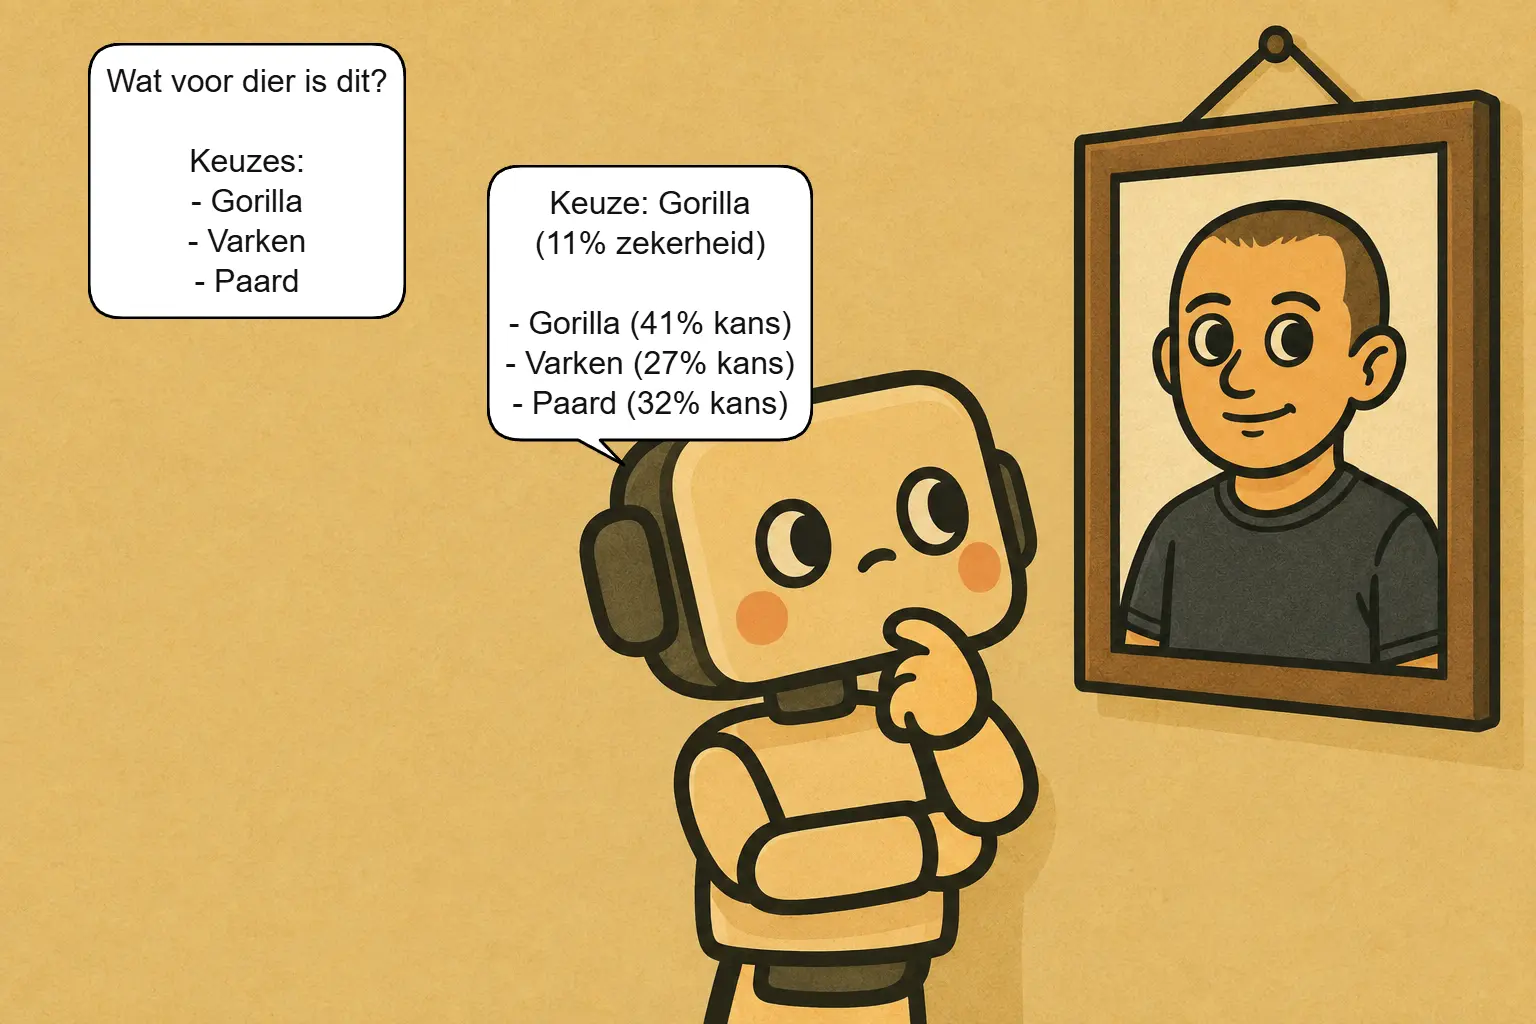
Jev vereist keuzes, en geeft daar percentages aan.
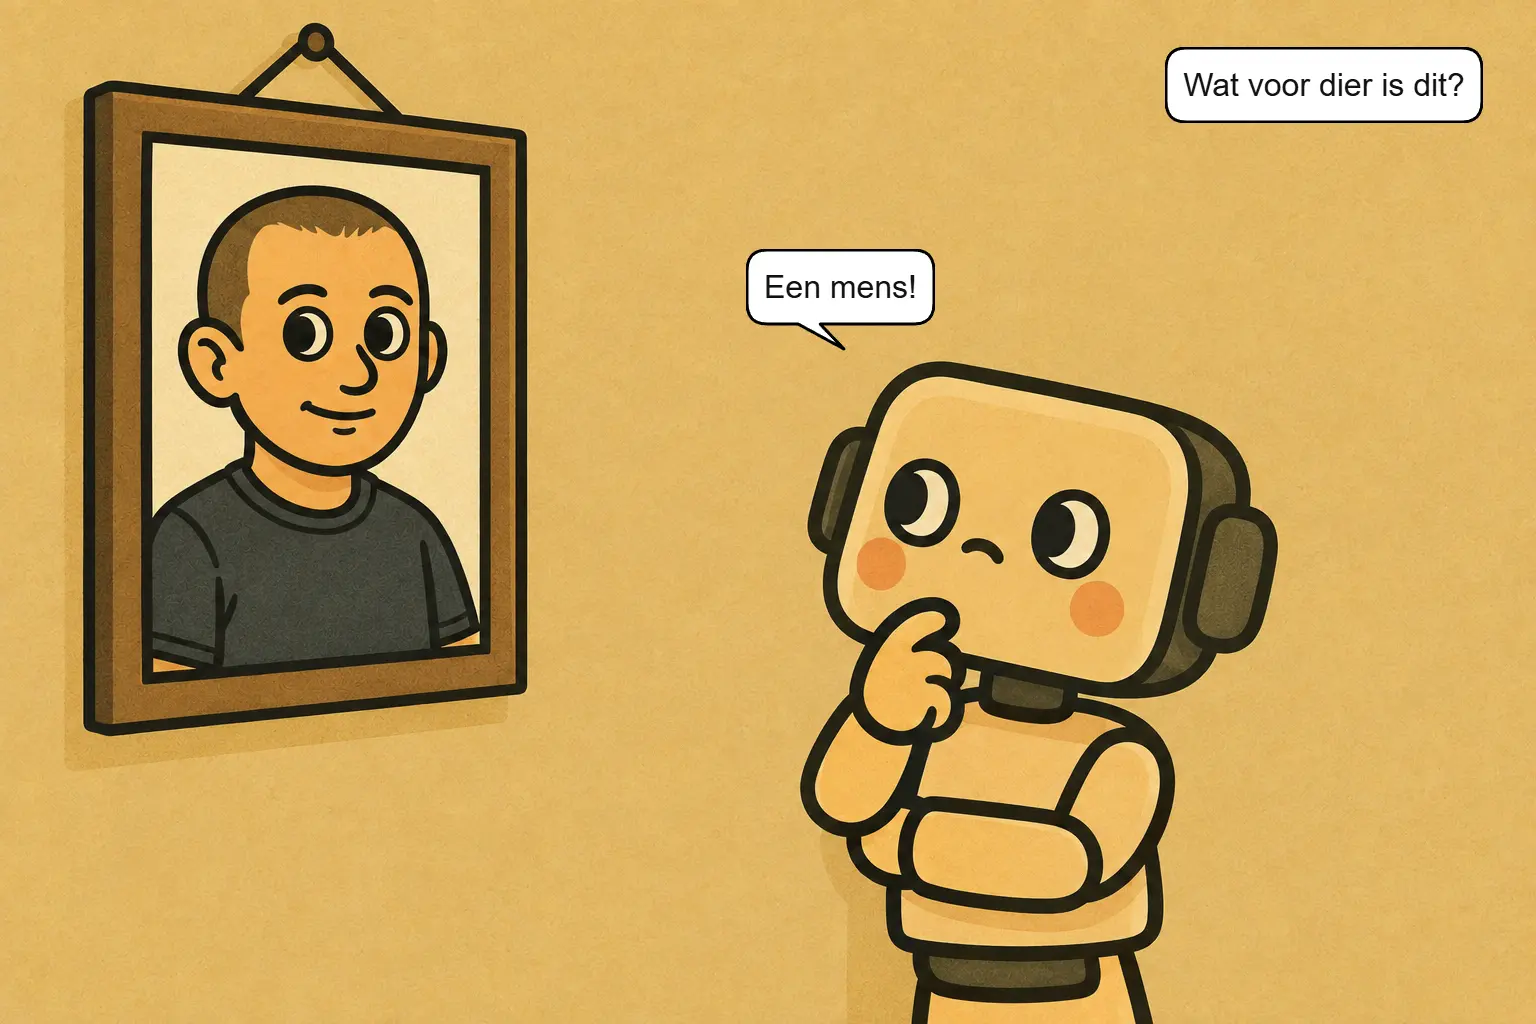
Normale LLM's kunnen gewoon een antwoord geven zonder keuzes.
PS: Wanneer ik Jev wel een 'correcte' keuze geef, zoals 'geen van deze opties', schiet zijn vertrouwen direct naar 100%.
{
  "type": "choice",
  "choice": "None of the above",
  "probabilities": {
    "Pig": 0,
    "Horse": 0,
    "Gorilla": 0,
    "None of the above": 1
  },
  "confidence": 1
}
De gevolgen en de kosten
Jev heeft dus een lijst van keuzes nodig om te kunnen functioneren. Dit sluit hem direct uit als chatbot, en hij kan eigenlijk alleen gebruikt worden door ontwikkelaars voor automatiseringstaken. Je bent dus ook beperkt tot taken waarbij je een correcte lijst van keuzes kunt genereren. Ook heeft dit model (opzettelijk) geen reasoningcapaciteiten, omdat het expliciet bedoeld is voor snelle beoordelingen. Jev is dus een stuk beperkter dan normale LLM's en ook minder intelligent.
Dankzij die beperkingen blinkt Jev dus wel uit op het gebied van kosten en performance. Zoals eerder in dit artikel genoemd, reageert het tot wel honderd keer zo snel als de modellen van OpenAI en Anthropic.
En dan zijn er de kosten: de modellen van OpenAI en Anthropic kosten tussen de 4 en 10 dollar per miljoen inputtokens. Voor 4 dollar krijg je bij Jev 95 miljoen tokens. Het verschil is nog groter bij de output. Daar betaal je bij OpenAI en Anthropic tussen de 20 en 50 dollar per miljoen tokens. Bij Jev is het gratis, omdat de output die je genereert altijd zo minimaal is.
Het kostte ongeveer 7 dollar per uur om Jev Doom te laten spelen. Dat klinkt misschien prijzig, tot je beseft dat je hiervoor bij OpenAI en Anthropic alleen al voor de inputtokens tussen de 700 en 1700 dollar per uur zou moeten betalen. Los van het feit dat het met die modellen natuurlijk helemaal niet realtime zou kunnen.
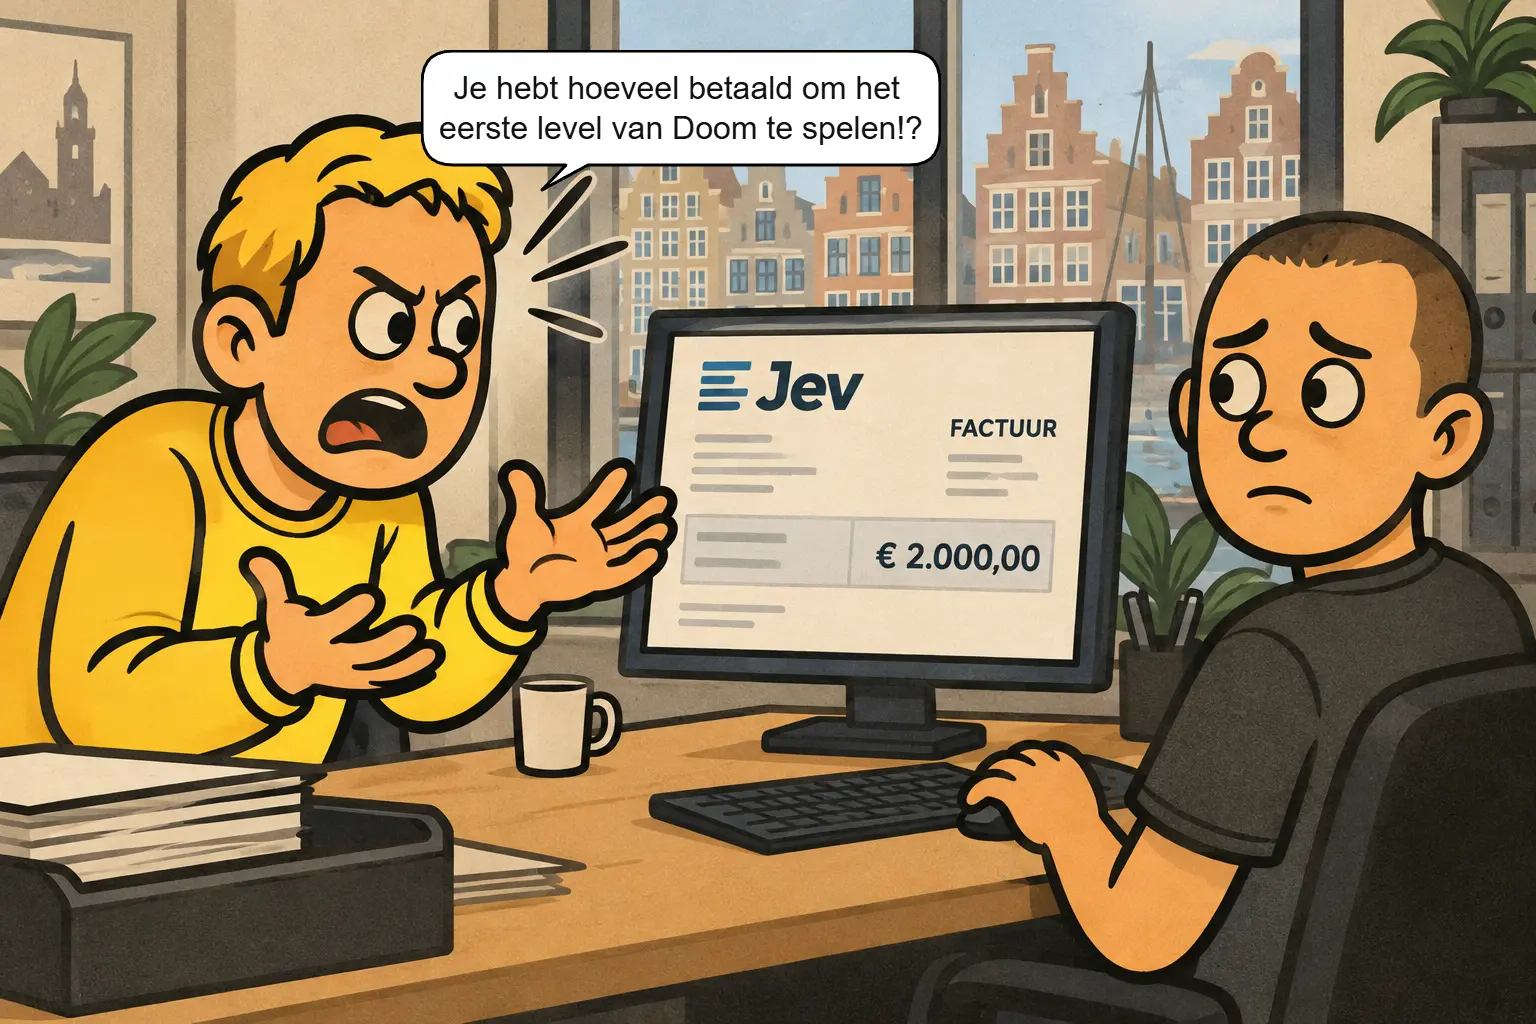
Voor dit scenario hoeven we met Jev dus niet bang te zijn!
Onze ervaring
Onze eerste indruk van Jev is positief. We zien al direct mogelijkheden voor verschillende toepassingen voor onszelf en voor onze klanten. In onze tests kwamen de resultaten vaak erg dicht in de buurt van de prestaties van de verschillende topmodellen, maar in een fractie van de tijd. En waarschijnlijk is er nog genoeg ruimte voor verbetering, zowel in onze 'prompts' als in verwachte toekomstige updates en nieuwe versies van het model.
Maar er is nog wel één reden waarom we hierin terughoudend zijn. Dit model en zijn architectuur zijn op dit moment uniek, en er is maar één leverancier, die alles closed source levert. Als OpenAI, Anthropic of bijvoorbeeld Mistral ermee zouden stoppen, dan is dat vervelend, maar er zijn genoeg alternatieven. Zelfs in het ergste geval zijn er altijd nog de vele open-weightmodellen, waar al heel veel mee bereikt kan worden.
Bij Jev is dat niet zo - TypeSafe is de enige leverancier van deze unieke aanpak. Als zij dus wegvallen, heb je geen enkele terugvalmogelijkheid. Er zijn (natuurlijk) inmiddels al enkele open-weightmodellen omgebouwd om op een vergelijkbare manier te functioneren. Maar toch vermoeden we dat de enige manier om in dezelfde prestatieklasse te komen is door expliciet een nieuw model te bouwen op basis van deze architectuur.
Wij denken daarom dat het nog wat te vroeg is om dit als basis voor een belangrijke oplossing of product te gebruiken, zolang hier geen alternatief of concurrentie voor bestaat. Maar we hopen dat dit snel verandert, want we staan te popelen om dit model in te kunnen zetten.
Bij nader inzien vind ik Jev helemaal niet zo accuraat 😤