In ons vorige artikel over Jev lieten we het model bepalen wat voor dier ik was. De keuzes waren een gorilla, een varken en een paard.
Er zat alleen een kleine kanttekening bij dat voorbeeld: Jev ondersteunde nog geen afbeeldingen. We stuurden dus geen plaatje van mij, maar een verhaaltje over 'Jeroen'. In de sidenote schreven we al dat ondersteuning voor afbeeldingen waarschijnlijk een kwestie van tijd was.
Nou, inmiddels is het zover. TypeSafe kondigde op 14 oktober Jev 1.14 aan, met ondersteuning voor afbeeldingen. Die mogelijkheid is trouwens ook beschikbaar gemaakt voor versie 1.13. Het is nog wel experimenteel: bij de eigen API van TypeSafe moet je het expliciet aanzetten, en TypeSafe vindt het nog niet betrouwbaar genoeg voor productiegebruik.
Voor een hernieuwd onderzoek naar mijn diersoort lijkt me dat geen groot bezwaar.
Drie keuzes
We gebruiken voor deze drie tests Jev 1.14 via OpenRouter. De vraag is steeds hetzelfde: "What animal is shown in the image?" Oftewel: wat voor dier staat er op het plaatje? We sturen alleen de afbeelding mee, zonder een verhaaltje over wie of wat erop staat.
Eerst krijgt Jev mijn getekende portret, met de keuzes Gorilla, Pig en Horse. Dezelfde drie dieren
als in het vorige artikel dus. Een mens staat er bewust niet tussen.
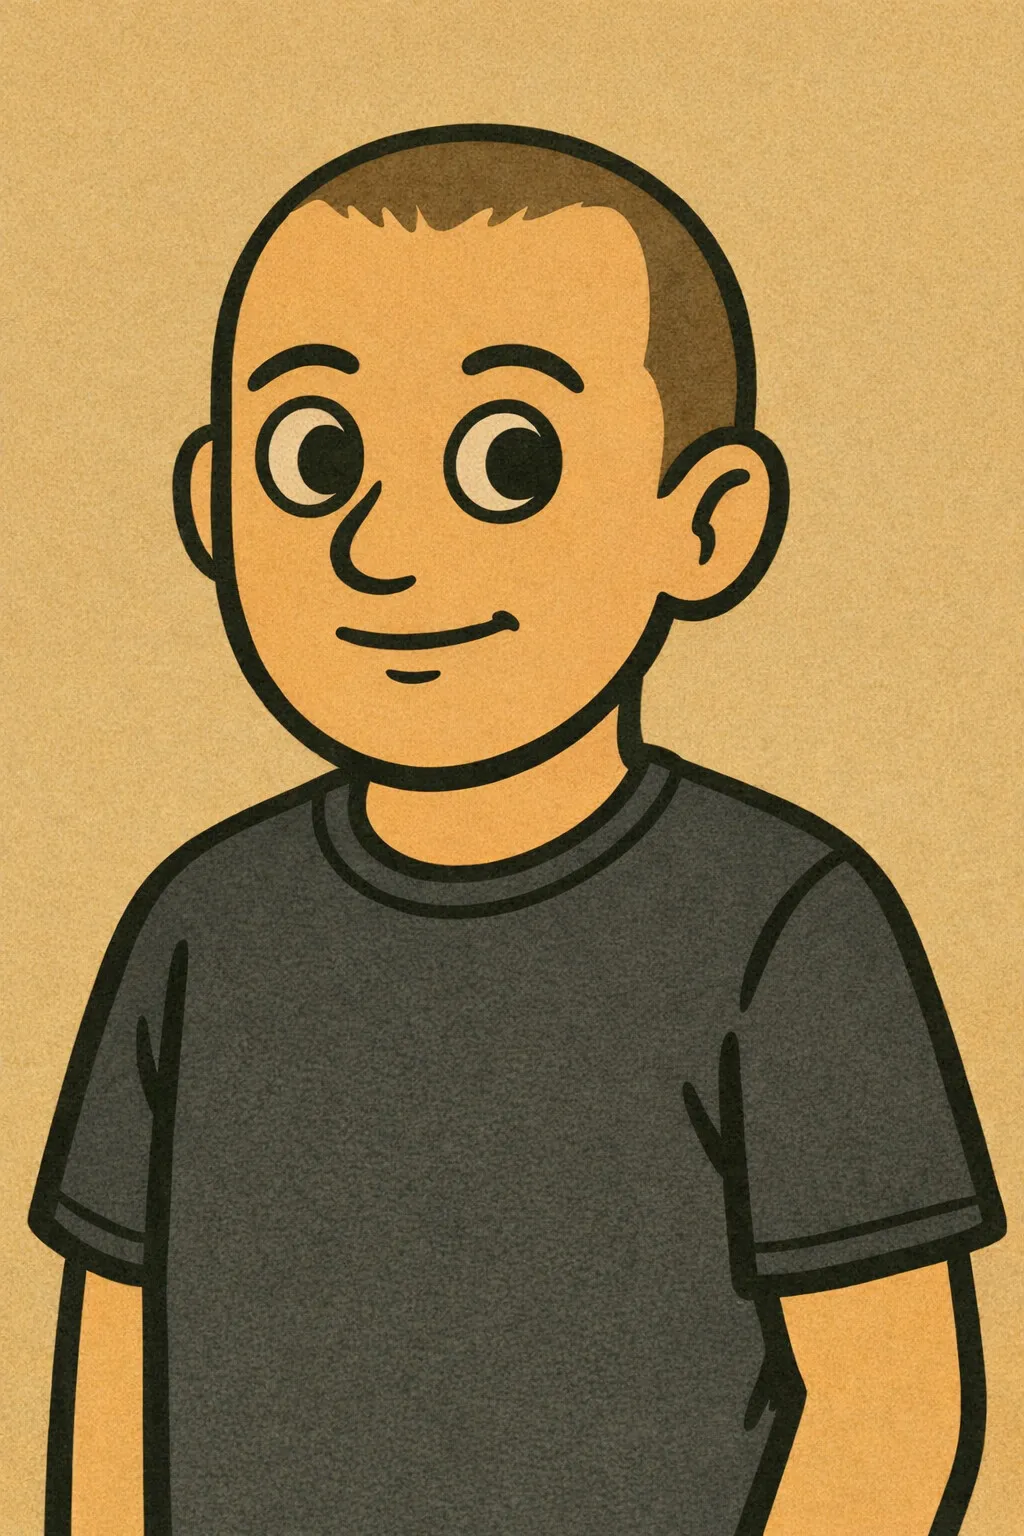
Het proefkonijn. Die optie staat er trouwens niet tussen.
Het antwoord is opnieuw gorilla. Dit keer kent Jev daar 63% kans aan toe, met een aparte confidence-score van 45%. Varken krijgt 30% en paard 7%. Hieronder staat het antwoordgedeelte uit de API-response:
{
  "type": "choice",
  "choice": "Gorilla",
  "probabilities": {
    "Gorilla": 0.63,
    "Pig": 0.3,
    "Horse": 0.07
  },
  "confidence": 0.45
}
Een uitweg
Voor de tweede test houden we het plaatje en de vraag precies hetzelfde. We voegen alleen een vierde
keuze toe: None of the above, oftewel 'geen van bovenstaande'. Jev krijgt dus de mogelijkheid om te
zeggen dat geen van die drie dieren past.
In het vorige artikel maakte die extra keuze een groot verschil bij het verhaaltje over Jeroen. Nu proberen we hetzelfde met het portret.
En inderdaad: nu kiest Jev voor 'geen van bovenstaande', met 100% voor die optie en een confidence-score van 100%.
{
  "type": "choice",
  "choice": "None of the above",
  "probabilities": {
    "Gorilla": 0,
    "Pig": 0,
    "Horse": 0,
    "None of the above": 1
  },
  "confidence": 1
}
De fotograap
Tot slot wisselen we alleen de afbeelding. De vier keuzes en de vraag blijven hetzelfde. Dit keer gebruiken we een stilstaand beeld uit de eerste video van ons artikel over MiniMax H3. Daarin blijkt de fotograaf een gorilla te zijn. De fotograap dus.
Het is een beeld uit een AI-gegenereerde video, geen foto van een echte gorilla. Maar voor de vraag wat er op het plaatje staat, is het natuurlijk wel een ander geval dan mijn getekende hoofd.
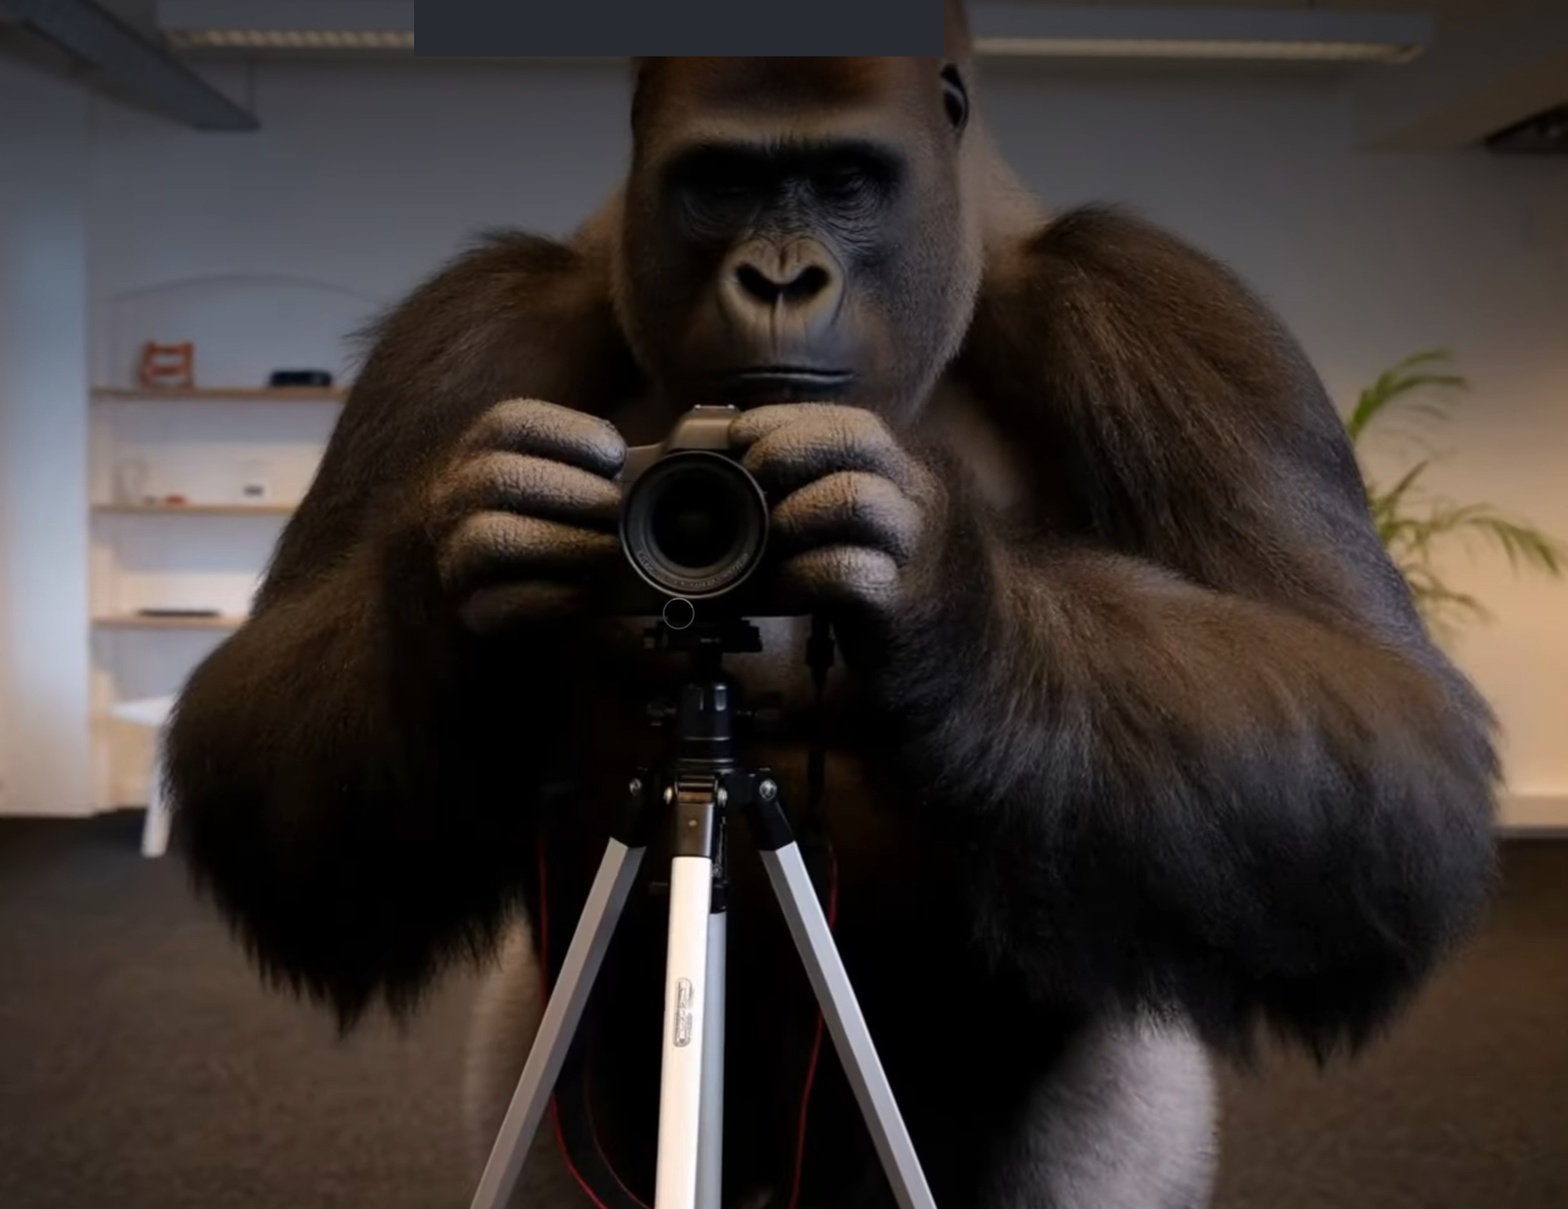
Ik vind de gelijkenis met mijzelf eigenlijk best treffend.
Dit keer kiest Jev voor Gorilla, met 100% voor die optie en opnieuw een confidence-score van 100%.
{
  "type": "choice",
  "choice": "Gorilla",
  "probabilities": {
    "Gorilla": 1,
    "Pig": 0,
    "Horse": 0,
    "None of the above": 0
  },
  "confidence": 1
}
Met dezelfde vier keuzes kan Jev in deze twee voorbeelden dus wel degelijk onderscheid maken tussen mijn portret en de gorilla.
Dit zijn drie losse API-calls, elk één keer uitgevoerd op 18 oktober. Geen uitgebreide benchmark dus. De percentages zijn de kansen die het model aan de opties toekent; de confidence-score geeft aan hoe duidelijk de hoogste kans boven een gelijke verdeling uitkomt. Ook 100% is geen garantie dat het model altijd gelijk heeft.
Het fictieve voorbeeld uit ons vorige artikel kunnen we nu in ieder geval met echte beeldinput uitvoeren. En de les over die keuzelijst blijft hetzelfde: als je alleen een gorilla, een varken en een paard aanbiedt, moet het model er toch eentje kiezen.
Jev ziet inmiddels het verschil tussen mij en een gorilla. Zelf ben ik daar nog niet helemaal van overtuigd.