Webenable
Techblog
Ons Techblog bevat artikelen, geschreven door onze developers, over dingen die ze zijn tegengekomen tijdens hun werkzaamheden. Deze artikelen gaan (meestal) over een technisch onderwerp, en zijn met name bedoeld om te vermaken en (soms) te informeren.
Artikelen met tag AI
 vrijdag 5 september 2025
Waarom al die CLI-applicaties voor AI?
Steeds meer AI-providers brengen CLI applicaties uit voor hun taalmodellen. Maar waarom eigenlijk? In dit artikel bespreken we de voordelen van de command-line interface, en of dit een logische keuze is van de AI-providers.
 vrijdag 22 augustus 2025
Model Uitgelicht - Gemma 3n 270m
Google heeft een nieuw Gemma-model uitgebracht, het kleinste model tot nu toe. Maar dit model heeft een heel ander doel dan de vorige modellen. Lees meer erover in dit artikel.
 maandag 11 augustus 2025
Model Uitgelicht - GPT-5 Aanvulling
De lancering van GPT-5 kreeg een gemixte receptie. Wat is er aan de hand? In dit artikel doen wij een kleine aanvulling op ons eerdere artikel en bespreken we de situatie.
 zaterdag 9 augustus 2025
Model Uitgelicht - GPT-5
OpenAI's langverwachte GPT-5 is eindelijk gelanceerd! We testen het nieuwe reasoning-model op vertalen, coderen, afbeeldingen beschrijven en tekstherkenning. Hoe presteert het ten opzichte van zijn voorgangers?
 vrijdag 8 augustus 2025
Model Uitgelicht - gpt-oss
OpenAI's eerste open-weights model sinds 2019 is eindelijk hier! Maar presteert gpt-oss wel zo goed als verwacht?
 vrijdag 1 augustus 2025
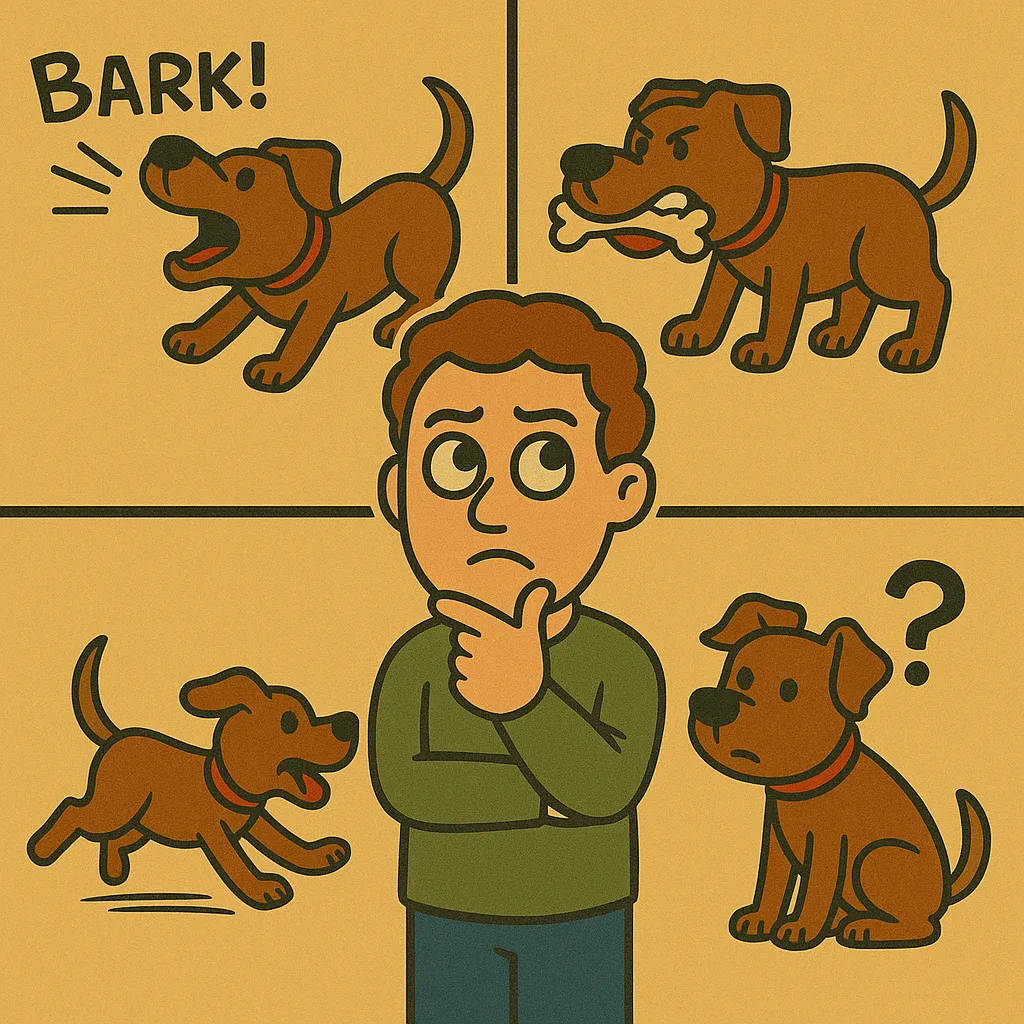
Wat is temperatuur
Een van de manieren om de output van een LLM te beïnvloeden is door de 'temperatuur' te verhogen of verlagen. Maar wat is precies temperatuur? En wat is de invloed van deze waarde op de output van een LLM? In deze post helpt een trouwe viervoeter ons dit concept uit te leggen.
 vrijdag 11 juli 2025
MCP uitgelegd - Deel 1: Wat is tool usage?
In deze blogserie leggen wij uit wat MCP is. Maar hier is eerst wat voorkennis voor nodig. Dat is waar dit eerste artikel in deze blogserie over gaat.
 vrijdag 4 juli 2025
Model Uitgelicht - Gemma 3n
In dit artikel nemen wij een kijkje naar het nieuwste Gemmaverse model.
 vrijdag 20 juni 2025
Vertalen met AI - Deel 2: It is exasperating to have squirrel food
In het vorige artikel hebben we ons gericht op simpele vertalingen. We willen het onze LLMs langzaam moeilijker gaan maken. Daarom springen we in dit artikel gelijk het diepe in met een rijmende idiomatische uitdrukking.
 dinsdag 10 juni 2025
Het recept voor een eindeloze taak
Soms is één keer koken kennelijk niet genoeg. Lees hier hoe ons experiment met lokale modellen en MCP servers anders liep dan verwacht.